前言
2026 年,人形机器人出现在工厂、仓库和实验室里的频率,已经高到让人有些麻木。视频里叠衣服、搬箱子、拧螺丝的片段每天都有新的,但真正值得写下来的变化不在视频里,而在产线的节拍表上:Figure 的第三代机器人在 BMW 工厂承担了实际的物料搬运工位,Agility 的 Digit 在商业部署中累计搬运超过 10 万个周转箱,宇树把 G1、R1 这类硬件的价格压到了过去只有实验室才敢想的区间。
三年前,这个行业的关键词是”能不能动”;两年前是”能不能听懂指令”;到了 2026 年,问题变成了”能不能连续干满一个班次,出错率是否低于人类,坏了谁来负责”。
这一转向的技术底座,是机器人基础模型(Robot Foundation Model)的成熟。本文想梳理的是:这一轮具身智能的进展究竟建立在什么之上,VLA 与世界模型的路线之争意味着什么,真机数据这道坎为什么这么难跨,以及当机器人真的走进产线时,工程与安全会提出哪些模型层面回答不了的问题。
一、从预编程到基础模型:机器人”大脑”的三级跳
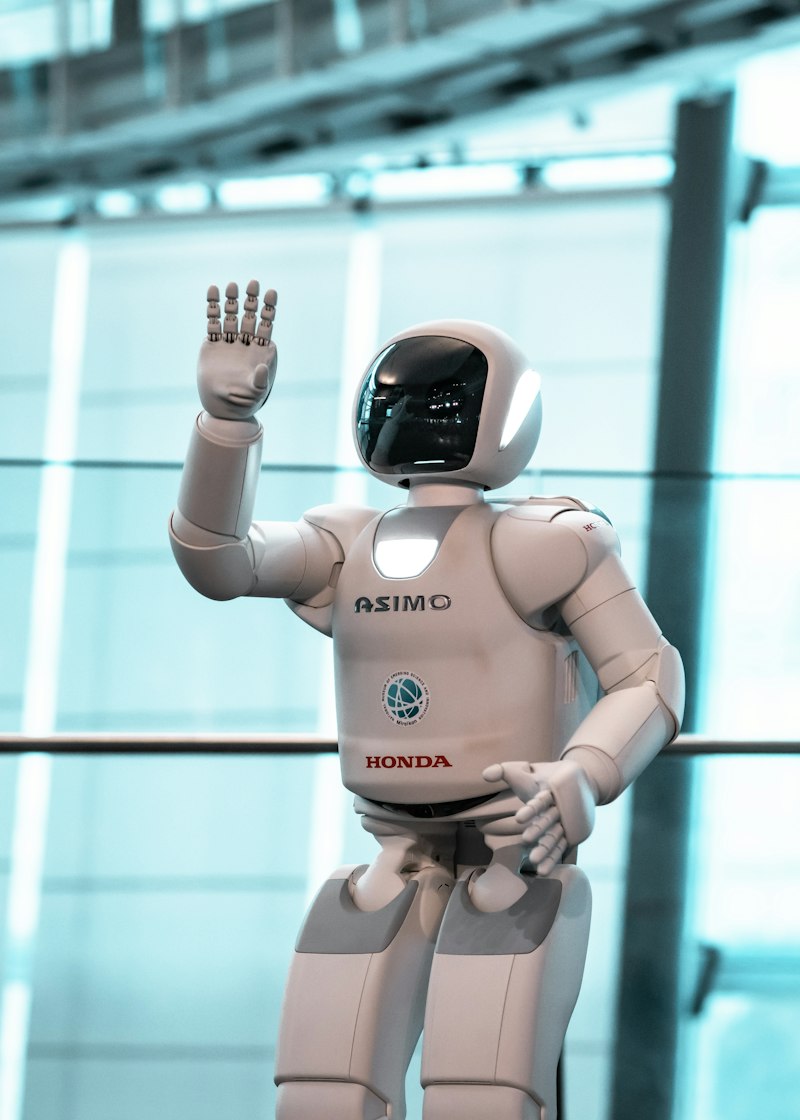
要理解 2026 年的进展,得先回看起点。上世纪 90 年代到 2010 年代,本田 ASIMO 代表了具身智能的第一次高潮:它能走路、上楼梯、挥手打招呼,动作优雅得令人惊叹。但 ASIMO 的每一个动作都是工程师逐帧编排的状态机,换一个场景就要重新写一遍代码。它演示的是控制工程的极致,而不是智能。
第二次跃迁发生在 2022 至 2024 年,模仿学习与大规模示教数据让机器人第一次具备了”从数据里学动作”的能力,但模型仍然任务专用——一个模型叠衣服,另一个模型开抽屉,彼此不通。
第三次跃迁就是当下:把视觉、语言、动作放进同一个模型,用互联网规模的语义先验去支撑物理世界的操作。这就是 VLA(Vision-Language-Action)范式的核心主张——机器人不必为每个任务重新编程,而是像人一样”看懂场景、听懂人话、做出动作”。
2026 年的代表性模型,基本可以把格局看得比较清楚:
| 模型 | 机构 | 关键特征 | 2026 年状态 |
|---|---|---|---|
| π0 / π0.6 / π0.7 | Physical Intelligence | 视觉-语言骨干 + 流匹配(Flow Matching)动作头,输出连续、平滑的动作轨迹 | π0.6 用真机强化学习把单任务推到极限;π0.7(2026.04)主打组合泛化,零样本跨本体叠衣 |
| GR00T N1 → N1.7 | NVIDIA | 基于 Isaac Lab 大规模仿真预训练,再叠加真机微调,强调跨形态迁移 | N1.6 于 2026 年 1 月发布;截至 2026 年 5 月,3B 的 N1.7 是中型主力版本 |
| Gemini Robotics 1.5 | Google DeepMind | 直接构建在 Gemini 多模态底座上,继承视觉理解与语言推理 | 灵巧操作能力突出,能完成叠衣、组装积木等精细任务 |
| GEN-1 | Generalist AI | 从零训练,主张”目标比方法更重要” | 2026 年 4 月发布,走的是与 VLA 微调路线不同的自研基座 |
| RynnBrain | 阿里达摩院 | 定位 System-2「具身大脑」,负责第一视角理解、时空定位与任务规划 | 2026 年 2 月开源,覆盖 2B/4B/8B/30B-A3B 多个规模 |
一个容易被忽略的细节是:这些模型的能力提升,很大一部分并非来自架构创新,而是来自数据配比的工程学。π0.6 的开放世界泛化之所以成立,是因为训练集里混合了多机器人数据、多模态网络数据(问答、caption、检测)、跨本体数据、多环境静态数据,以及带高层语义子任务标注的口头指令。消融实验显示,一旦抽掉跨本体数据,泛化能力会大幅退化。这说明”机器人基础模型”本质上是一个数据工程问题,而不是单纯的模型规模问题。
二、VLA 不是全部:世界模型补上”物理直觉”
2026 年行业里最热闹的争论,是”世界模型会不会取代 VLA”。
先把两个概念分开:VLA 回答的是”看到这个场景、听到这句话,我该输出什么动作”;世界模型回答的是”如果我这样推一下,接下来会发生什么”。前者是策略,后者是物理直觉与想象力。
这场争论的现实背景是,纯 VLA 路线在长时序、多阶段任务上确实吃力。一次抓取失败意味着任务中断,一次路径偏差意味着碰撞风险,而 VLA 的单次推理延迟通常在 100 到 500 毫秒之间——对于需要 50Hz 以上控制频率的精细操作,这个延迟远远不够。业界的缓解手段是”动作分块”(Action Chunking),一次推理输出未来若干步的动作序列,但这是工程补丁,不是根本解法。
世界模型提供的补强有三层:其一是物理预测,让模型在动作执行前预判后果,把试错成本挪到想象里;其二是合成数据,用可交互的仿真环境批量生成训练样本,绕开真机采集成千上万小时的瓶颈;其三是长程规划,用对未来的模拟来支撑多阶段任务的分解。
NVIDIA 在这条线上押注最重,Cosmos、GR00T、Isaac Lab 与 Physical AI Data Factory 构成了一套从仿真到数据的完整栈。学术侧的探索也在加速:GigaBrain-0.5M 提出的 RAMP 思路,把世界模型同时当作数据引擎(约占预训练经验的 61%)和强化学习引擎,相当于让模型自己造练习题、自己判卷。
但更值得记录的,是产业界对这场”路线之争”的降温。仙工智能在 2026 年的一篇公开讨论里给出了一种更务实的判断:具身智能的大脑从来不等于某一个大模型,VLA 负责感知-理解-动作的主链路,世界模型补强预测与泛化,控制系统保证实时性与安全边界,真实场景数据驱动持续校正——四者互不替代。这个看法在工程上很难反驳:把任何一个环节抽掉,系统都跑不起来。
三、真机数据:最贵的那一公里
如果说大语言模型的燃料是互联网文本,那么具身智能的燃料只能靠一条条真实操作攒出来。这是这个领域最核心、也最难绕开的瓶颈。
一条机器人操作数据的成本,包括机械臂折旧、场地、操作员时间、失败重试,以及标注。语言模型可以在一周内读完人类几百年的文字,机器人却需要有人握着示教器,一遍遍演示”把杯子放进洗碗机”。
π0.6 的实验给出了一个相对乐观的量化参照:当训练环境从 3 个扩展到约 104 个地点、累计约 400 小时后,模型在 3 个从未见过的真实住宅里,表现已经逼近直接在测试环境训练的基线。换句话说,跨环境的数据多样性,比单一环境的深度更重要。这解释了为什么 2026 年的头部团队都在疯狂扩大采集点,而不是把一个场景拍到极致。
仿真补足了另一半。Isaac Lab 这类平台可以在虚拟环境里并行跑成千上万个机器人,把罕见工况、极端光照、材料形变都造出来。但 sim-to-real 的鸿沟依然存在:摩擦系数、柔性体形变、传感器噪声、光照分布,仿真都无法完美复刻。实践中的常见做法是”仿真预训练 + 少量真机微调”,用真机数据去校准那些仿真里学不到的偏差。
一个正在成形的分工是:仿真负责广度,真机负责精度,世界模型负责在两者之间做插值。这条链路的成熟度,直接决定了机器人基础模型能否从”演示可用”走到”产线可用”。
四、工程化落地:延迟、可靠性与安全边界
模型在论文里强,和在产线上强,是两件不同的事。
产线对机器人的要求,可以用三个词概括:节拍、稳定、可追责。
节拍意味着延迟预算被写死。VLA 推理 100 到 500 毫秒的响应时间,放在需要高频闭环的力控场景里是灾难性的,因此主流方案都是分层:高层用离散 token 或语言生成子任务,底层用动作专家输出约一秒(50 步左右)的连续关节动作块,再由实时控制器做插值与安全裁剪。
稳定意味着失败要被限制在局部。工业现场没有试错空间,一次抓取失败就是一次停线,一次控制抖动就意味着”只能演示、无法规模化”。这也是为什么 2026 年的落地集中在搬运、上下料、分拣、质检这类结构化程度高、容错窗口相对宽的工位——Figure 在 BMW 承担物料搬运,Agility 的 Digit 在仓库搬周转箱,都是这个逻辑。
可追责则牵出了模型层面回答不了的问题。当机器人造成人身伤害或财产损失时,责任如何在模型提供方、整机厂商、集成商与使用方之间分配?目前国际上的功能安全标准(如 ISO 10218 系列、ISO/TS 15066)主要针对传统工业机器人的人机协作,对”由基础模型驱动的行为”缺乏清晰的判定依据。这是 2026 年一个明显滞后的领域。
中国的政策端则在加速铺路。2025 年”具身智能”首次写入政府工作报告,随后多地出台了具身智能与人形机器人的专项行动方案,从算力补贴、场景开放到首台套保险都有涉及。MERICS 在 2026 年的研究报告里指出,中国的路径特点是把制造业场景、供应链配套与政策资源三者绑定推进,这与美国以基础模型公司为核心的路径形成明显差异。
五、产业格局:钱在往哪里流
从资本侧看,2025 至 2026 年是机器人基础模型最密集的融资窗口。Figure 在 2025 年 9 月估值达到 390 亿美元,Physical Intelligence 在 2025 年 11 月估值 56 亿美元,Skild AI 在 2026 年 1 月估值超过 140 亿美元。一级市场的定价已经明显走在收入前面。
市场规模的口径差异很大,但方向一致。Meticulous Research 在 2026 年 10 月发布的报告给出:全球机器人基础模型市场 2025 年约 6.2 亿美元,2026 年约 9.9 亿美元,到 2036 年可达 248.5 亿美元,2026–2036 年复合增长率 38.0%。
国内的进展则更贴近场景。智元机器人在 2025 年 12 月展示了 VLA 驱动的全身协同控制——行走与操作同时完成;银河通用在 2025 年 6 月完成 11 亿元融资;美的在 2025 年 12 月发布了六臂协同的工业人形”美罗 U”;宇树、优必选、傅利叶则在硬件成本与形态上持续下探。一个普遍判断是:国内模型在特定垂直场景(如工业操作)的性能已接近国际水平,但在通用操作泛化上仍有差距。
六、挑战与展望:别把”验证年”当成”爆发年”
如果把 2026 年放在更长的时间轴上看,它更像一个验证年,而不是爆发年。几条边界需要保持清醒:
第一,评测体系尚未统一。 大量模型的性能数字来自 LIBERO 这类仿真基准上的自评,真机、跨本体、长时序任务的公开对比依然稀缺。实验室自评与第三方复现之间的落差,是这个领域目前最大的信息噪声来源。
第二,成本曲线还没到位。 硬件价格在下探,但整机之外的集成、部署、维护、安全认证成本仍然高昂。一台能在产线上稳定干活的机器人,其全生命周期成本远高于标价。
第三,泛化的边界比演示视频窄。 视频里机器人叠衣服,往往是在有限衣物类型、固定台面高度、稳定光照下的结果。换一批衣物、换一个厨房,成功率会明显下降。
第四,安全与责任框架滞后于技术。 这一点在工业场景尚可用护栏与急停兜底,一旦进入家庭与公共空间,问题会立刻变得尖锐。
但悲观也没有必要。回看汉斯·莫拉维克在 1980 年代提出的那个悖论——让计算机在智力测验上达到成人水平相对容易,而让它具备一岁小孩的感知与运动能力却极其困难——过去四十年里,这条悖论一直是机器人学的诅咒。2026 年第一次出现了松动的迹象:语言与视觉模型把”常识”带了进来,世界模型把”预判”带了进来,大规模真机数据把”手感”带了进来。三者叠加,让机器人在少数场景里第一次越过了”能用”的门槛。
结语
这一轮具身智能的进展,最容易被误读成”又一个模型刷新了榜单”。但真正决定成败的,是那些不在榜单上的东西:一条产线的节拍、一小时真机数据的成本、一次失败的责任归属、一套控制系统的实时性。
机器人不会因为某个模型变大而突然聪明,它会因为数据、控制、场景三件事同时到位,而慢慢变得可靠。2026 年值得记住的,不是哪个模型赢了路线之争,而是行业终于开始用”能不能连续干一个班次”来衡量进展——这是一个更笨、更慢,但也更接近真实世界的标准。
参考来源
- Robotics Center, Physical AI in 2026: Foundation Models for Robot Learning and Real-World Deployment
- Meticulous Research, Robot Foundation Models Market Size & Forecast 2036(2026 年 10 月)
- MERICS, Embodied AI: China’s ambitious path to transform its robotics industry(2026)
- 声网技术博客,《视觉语言动作模型(VLA)是什么?具身智能的”大脑”如何运转》
- 具身星图,《VLA 模型发展深度调研报告》(2026)
- 仙工智能,《世界模型对决 VLA 大模型,具身智能最终走向何方?》(2026)
- KPMG 中国,《跨越奇点:世界模型如何重塑具身智能产业与商业新范式》(2026 年 7 月)
- Sapkota et al., Embodied AI with Foundation Models for Mobile Service Robots: A Systematic Review, arXiv:2505.20503;Robotics 2026, 15(3), 55
- Robozaps, The Future of Humanoid Robots: What 2026 Is Actually Proving
说明:文中涉及的市场规模、估值与模型版本信息截至 2026 年 10 月,部分模型性能数据来自机构或实验室自评,尚未经第三方独立复现,阅读时请留意口径差异。